名寄せとは?意味をわかりやすく
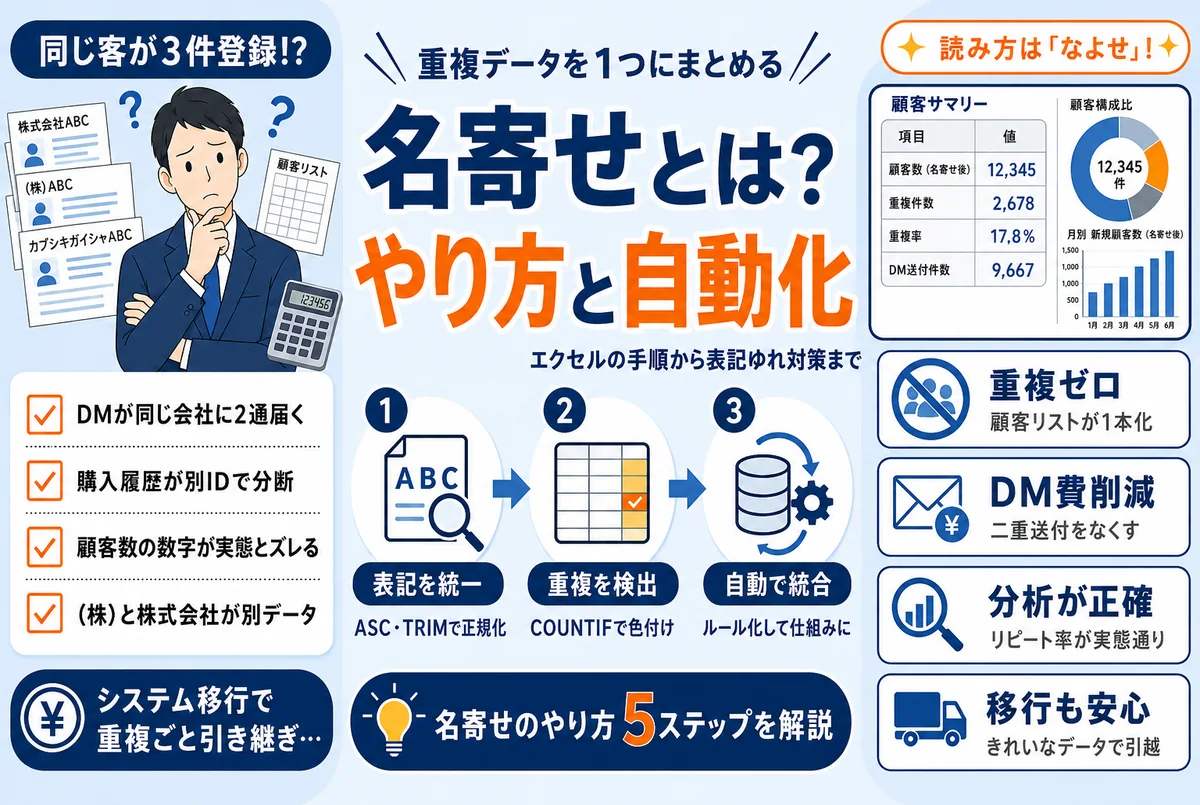
名寄せ(なよせ)とは、複数のデータベースやリストに散らばって登録されている同一人物・同一企業の情報を、「同じ相手」として1つにまとめる作業のことです。
たとえば、次のような状態を解消するのが名寄せです。
- 顧客管理システムに「株式会社山田商事」と「(株)山田商事」が別々の会社として登録されている
- ECの購入者リストと問い合わせリストに同じ人が別IDで存在し、購入履歴が分断されている
- 展示会の名刺リストと既存顧客リストを統合したら、同じ担当者が二重に登録された
なお「名寄せ」には、金融の世界でのもう1つの意味があります。預金保険制度(ペイオフ)における名寄せで、これは金融機関が破綻した際に、同一預金者の複数口座を合算して保護額(元本1,000万円まで等)を算定するための作業を指します。銀行にとっての義務的な業務であり、仕組みとしては本記事の名寄せと同じ「同一人物のデータをまとめる」作業です。本記事では、一般企業の実務で発生する顧客・取引先データの名寄せを中心に解説します。
なぜ名寄せが必要か——重複データが引き起こす4つの実害
名寄せは地味な作業ですが、放置した重複データは確実に実害を生みます。
| 実害 | 具体例 |
|---|---|
| コストの無駄 | 同じ会社にDM・カタログが2通3通届く。郵送費も印象も悪い |
| 機会損失 | 購入履歴が分断され、優良顧客を「新規」扱いしてしまう |
| 分析が狂う | 顧客数・リピート率などの数字が実態とずれ、判断を誤る |
| 信頼の毀損 | 「先日もご案内しましたが」と別担当が重複連絡し、相手に不信感を与える |
特にこれから顧客管理システム(CRM)の導入やシステム移行を控えている場合、名寄せをせずにデータを流し込むと、重複ごと新システムに引き継がれます。移行前の名寄せは、後回しにできない準備作業です。

名寄せのやり方5ステップ
名寄せの基本手順は、データの規模を問わず共通です。
- ステップ1: データを1か所に集める——Excel・システム・名刺アプリなど、散らばったリストを1つの表に集約する
- ステップ2: 表記を統一する(正規化)——全角半角・スペース・「株式会社/(株)」などの表記を機械的にそろえる
- ステップ3: 突き合わせのキーを決める——何が一致したら同一とみなすか(メールアドレス、電話番号、会社名+氏名など)を決める
- ステップ4: 候補を抽出して判定する——キーが一致・類似するペアを洗い出し、同一か別人かを判定する
- ステップ5: 統合ルールを決めて1つにまとめる——どちらの住所を正とするか、履歴はどう引き継ぐかを決めて統合する
つまずきやすいのはステップ2と4です。表記ゆれを甘く見ると、ステップ4で「同じ会社なのに一致しない」ペアが大量に残り、結局すべて目視で確認する羽目になります。2つのデータを突き合わせて確認する作業の考え方は突合とは?意味と自動化の方法でも詳しく解説しています。
エクセルでの名寄せのやり方(関数と限界)
数百〜数千件規模なら、エクセルでもかなりの名寄せができます。使う関数はこのあたりです。
| 目的 | 関数・機能 | 使い方の例 |
|---|---|---|
| 表記の統一 | ASC/JIS、TRIM、SUBSTITUTE | 全角半角の変換、余分なスペース除去、「(株)」→「株式会社」の置換 |
| 重複の検出 | COUNTIF、COUNTIFS | 会社名+電話番号の組み合わせが2件以上あれば重複候補として色付け |
| 突き合わせ | XLOOKUP/VLOOKUP | リストAの相手がリストBに存在するかを検索して並べる |
| 完全一致の削除 | 「重複の削除」機能 | 整えたキー列で機械的に重複行を削除 |
ポイントは、いきなり「重複の削除」をしないことです。表記ゆれが残ったまま削除機能を使うと、「(株)山田商事」と「株式会社山田商事」は別データとして両方残り、名寄せしたつもりで重複だらけ、という結果になります。必ず正規化(表記統一)→検出→目視確認→削除の順で進めてください。
そしてエクセルの限界は、「毎回同じ手作業をくり返すことになる」点です。月次でリストが増えるなら、毎月同じ関数整備と目視確認が発生します。ここが自動化の出番です。
名寄せを自動化する方法と、機械に任せられない部分
毎月・毎週発生する名寄せは、正規化ルールをプログラム(Excelマクロ・GAS・Python等)に落とし込むことで大部分を自動化できます。構築の外注費用は対象データの複雑さにもよりますが、5〜20万円程度が目安です。
ただし、すべてを機械に任せられるわけではありません。弊社が実際に手がけた、記録データと顧客台帳を名前で自動照合する案件では、照合を外す原因は次の4パターンに分類できました。
- 名前以外の文字の混入(管理記号など)——機械で吸収できる
- 全角半角・スペースなどの表記ゆれ——機械で吸収できる
- 旧字体・異体字(「山﨑」と「山崎」など)——変換表でおおむね吸収できる
- 「朗」と「郎」のような一字違い——本当に別人の可能性があるため、機械が勝手に判断してはいけない
つまり実務的な最適解は「完全自動化」ではなく、機械が判断できるものは自動でまとめ、疑わしい少数だけを人が確認するという設計です。この線引きの実例は名前の表記ゆれで照合が合わない問題の実例で詳しく書いています。あわせて、日々のデータの移し替え自体を減らす考え方は転記作業の自動化をご覧ください。
まとめ:名寄せは「一度きり」で終わらせない
名寄せとは、散らばった同一人物・同一企業のデータを1つにまとめる作業。やり方は「集める→表記を統一→キーを決める→判定→統合」の5ステップで、エクセルでも小規模なら対応できます。
ただし本当の課題は、名寄せは一度やって終わりではないことです。データは毎日増え、重複も毎日生まれます。だからこそ、正規化ルールを自動化に落とし込み、「重複が生まれにくく、生まれてもすぐ検出される」仕組みにしておくことが、名寄せ作業を根本からなくす道です。
その顧客リストの重複、自動で整理できる?AIに30秒で診断
いまのデータの状態を1行入力するだけ。名寄せ・重複整理の進め方を、その場でお見せします。月額3万円〜・最短2週間で運用開始。
AIに30秒で試す →よくある質問
Q. 名寄せの読み方と意味を簡単に教えてください。
「なよせ」と読みます。複数のリストやデータベースに別々に登録されている同一人物・同一企業の情報を、同じ相手として1つにまとめる作業のことです。金融では預金保険制度(ペイオフ)で同一預金者の口座を合算する作業も名寄せと呼びます。
Q. エクセルだけで名寄せはできますか?
数百〜数千件規模なら可能です。ASC・TRIM・SUBSTITUTEで表記を統一し、COUNTIFで重複候補を検出、XLOOKUPで突き合わせる流れが基本です。ただし表記ゆれを整えないまま「重複の削除」を使うと重複が残るため、必ず正規化を先に行ってください。
Q. 名寄せで一番難しいのは何ですか?
表記ゆれの吸収です。「株式会社/(株)」・全角半角・スペース・旧字体などの違いで、同じ相手が別データに見えてしまいます。大部分は正規化ルールで機械的に吸収できますが、一字違いの氏名など本当に別人の可能性があるものは、機械に任せず人が判定すべき領域です。
Q. 名寄せの自動化はいくらくらいでできますか?
対象データの件数と汚れ具合によりますが、正規化+重複検出+突き合わせの仕組み構築で5〜20万円程度が目安です。毎月発生する名寄せ作業が数時間規模なら、数か月で回収できる水準です。